Vores agenter drak al kaffen
Vores kodeagenter pusher, venter på CI, retter og pusher igen, hele dagen. Da testsuiten voksede til to en halv gang størrelsen på en uge, stod hver CI-kørsel atten minutter ved kaffemaskinen. Sådan fik vi det ned på omkring tre minutter for de samme penge, og hvad der stod tilbage og ventede, da maskinerne ikke længere kunne bruges som undskyldning.
Der findes en xkcd om den bedste undskyldning, en programmør nogensinde har haft, og det meste af min karriere var den en dokumentar. Man pushede en commit og gik ud i køkkenet. Man så kaffemaskinen male bønner. Man drev ud til rygerne, for det var dér, de rigtige beslutninger blev truffet, og så kom man tilbage. Kørte stadig. Buildet var den eneste pause, nogen havde lov til at tage.
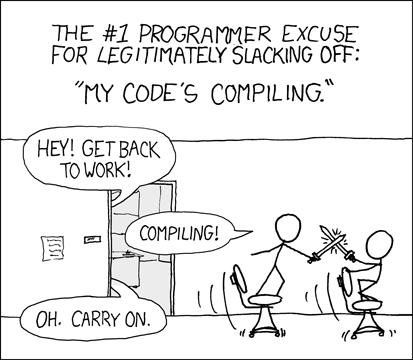
xkcd #303, “Compiling” af Randall Munroe, CC BY-NC 2.5
Du kender følelsen. Du har en rettelse. Den er lille, den er klar, den mangler bare et grønt flueben. CI siger tyve minutter. Så du gør det fornuftige og går i gang med noget andet, og når kørslen er færdig, er du dybt inde i det. Du kigger efter frokost. Den er rød: en flaky test eller en konflikt med noget, der er blevet merget i mellemtiden. Du retter det, pusher, venter igen og vender tilbage til det i morgen. En ændring på en time har taget to dage, og næsten ingen af den tid gik til selve ændringen. Alt, hvad du ville, var at komme igennem checks og videre.
I år fik buildet nyt selskab ved kaffemaskinen: vores kodeagenter. I september ventede de atten minutter på hver eneste kørsel. Her er, hvordan det blev til omkring tre, for de samme penge, og hvad vi fandt for enden af køen, da maskinerne ikke længere kunne bruges som undskyldning: os.
Hvem der venter på CI nu
Det meste af vores team arbejder nu med kodeagenter, især Claude. En typisk udvikler her har fire eller flere agent-sessioner kørende på samme tid.
Hver af de sessioner arbejder i en løkke. Den skriver ændringen, pusher den, venter på CI (continuous integration: robotten, der bygger og tester hver ændring), læser, hvad der fejlede, retter det og pusher igen. Først når checks er grønne, reviewer et menneske den, med CodeRabbit som et ekstra sæt øjne, og et menneske merger den og beslutter, hvornår den når produktion.
Det forvandler CI fra noget, et menneske tjekker en eller to gange i timen, til noget, hver agent på teamet venter på, hele dagen. På GitHub Actions gik vi fra 48 kørsler per arbejdsdag i juni til 375 i september. Mergede pull requests gik fra omkring 140 om måneden i foråret til 583 i september. GitHub fakturerer per minut, og regningen gik fra omkring 29 dollar i juni til 135 dollar for september, med et par dage endnu tilbage.
Så blev vores primære webapplikation langsom, fordi vi havde skrevet en masse tests. I én uge i september, mens vi byggede et nyt admin-API, voksede suiten fra omkring 3.900 tests til omkring 9.600, de fleste af dem tests, der starter hele applikationen og taler med en rigtig database. En typisk pipeline-kørsel gik fra under seks minutter til atten, og en dårlig tog syvogtyve. Jobs sad ikke fast i en kø. Maskinen havde to CPU’er, to en halv gang så meget arbejde, og vi havde lige bedt den om at køre otte testprocesser på én gang.
En pull request her får typisk to CI-kørsler, før den er færdig, og en fjerdedel får fire eller flere, mest opfølgende pushes frem for fejl. Ved atten minutter per kørsel er det over en halv time per ændring, før et menneske overhovedet kigger på den, og med fire eller flere sessioner per udvikler står mindst fire ændringer altid ved kaffemaskinen.
Ikke en VPS
En kollega var den første, der sagde det højt: det her gør os alle sammen langsommere. Forslaget var en VPS, en lejet virtuel server. Lej en stor en, installér GitHubs runner-software (den agent, der samler CI-jobs op) på den, færdig. Det ville have virket.
Jeg var alligevel ikke vild med det. En selvhostet runner er et kæledyr. Nogen skal patche den, holde Docker sund på den, installere de rigtige sprog og versioner til hvert repository, der bruger den, tømme disken, når et build fylder den, og opdage det, når den er nede en lørdag. Jeg vil hellere have, at ingen på et team af vores størrelse bruger deres uge på det. Så jeg ledte efter noget hostet i stedet, men først rettede jeg testene.
Først testene, så maskinerne
Den første rettelse var almindeligt ingeniørarbejde, og den stod for det meste. Testene kørte allerede parallelt, men med en masse spild omkring dem: hver test-worker byggede sin egen kopi af databasen, databasen gemte omhyggeligt hver skrivning på disk, som om det betød noget, og den samme kode blev kompileret igen i hver proces. Så nu ligger testdatabasen i hukommelsen, den bygges én gang og kopieres til hver worker, og suiten er delt op i fire jobs, der kører samtidig. Opdelingen er bevidst dum: tæl testene i hver fil, vægt de langsomme typer tungere, og del filerne ud, tungeste først, til det job, der har mindst indtil videre. De fire jobs bliver ikke helt færdige på samme tid, og vægte baseret på faktiske tider er det oplagte næste skridt.
Databaseopsætningen gik fra 76 sekunder til under 30, testene brugte halvt så meget regnekraft, og på GitHubs standardmaskiner var pipelinen nede på omkring fem minutter. Men hvert af de fire jobs betaler nu for sin egen opsætning, så de fakturerede minutter per kørsel blev liggende på omkring 21, det samme som den langsomme pipeline havde kostet. Vi ventede omkring en fjerdedel så længe for den samme regning.
Samme dag, som testrettelserne landede, oprettede jeg en prøveperiode hos Blacksmith, den hostede løsning med den nemmeste opsætning. Blacksmith sælger det samme som GitHub, en maskine, der kører dine GitHub Actions-jobs, bortset fra at man kan vælge større og hurtigere. Man installerer ingenting. Man ændrer én linje per job:
runs-on: blacksmith-4vcpu-ubuntu-2404 # was: ubuntu-latest
Lige efter tilmeldingen bad jeg Blacksmith om at køre vores jobs i deres EU-region. CI bør kun nogensinde se testdata, aldrig en klubs eller en golfspillers. Skulle nogen komme til at træde forkert, står maskinerne i EU alligevel. De skiftede det inden for en dag. Der ligger ingen aftale bag dette indlæg: vi tog prøveperioden og betaler nu normalpris. Vil vi nogensinde væk igen, er det den samme ene linje tilbage.
Med de fire testjobs på Blacksmith har pipelinen kørt 62 gange siden. Medianen er 2,8 minutter, og ni ud af ti kørsler bliver færdige på under 3,7.
Tuning og opdeling tog en typisk kørsel fra atten minutter til omkring fem. Maskinerne tog den fra fem til under tre, og en del af det er simpelthen flere kerner, fordi to CPU’er blev til fire. Jeg testede ikke GitHubs egen runner med fire kerner, som findes og koster 0,012 dollar i minuttet, det dobbelte af prisen for to CPU’er, så noget af gevinsten er penge, enhver GitHub-kunde kunne vælge at bruge.
Hvad der ændrede sig, og hvad der ikke gjorde
Jeg forventede, at hele løkken ville falde sammen. Så jeg målte det og sammenlignede pull requests fra den langsomme uge med de fem dage siden skiftet.
Den del, CI styrer, faldt faktisk sammen. Fra en pull request blev åbnet til dens første grønne kørsel tog det en median på 17,5 minutter i den langsomme uge. Nu er det 3,1. Det er ventetiden, hver ændring betaler, før review, og den er fem gange kortere.
Den del, jeg troede ville følge med, gjorde ikke. Når en kørsel fejler, er tiden til den næste grønne en median på omkring en halv time, før og efter (kun en håndfuld tilfælde hver uge, så tag det med et gran salt). Hurtigere maskiner kunne ikke røre ved den. Færre end én pull request ud af ti bliver rød, og de få, der gør, ligger for det meste, indtil et menneske tager fat i dem, nogle gange først næste morgen. Agenterne giver sjældent CI noget, der er i stykker. Den langsomme del af vores løkke er nu os.
Hvad det koster, og to lærestreger
Én pipeline-kørsel af den primære webapplikation plejede at fakturere omkring 21 minutter på GitHubs maskine med to CPU’er, cirka 13 cent. På Blacksmith fakturerer den samme kørsel omkring 16 minutter, de fleste på de større maskiner, og lander på 12 eller 13 cent, alt efter hvordan man runder. De samme penge altså, for en kørsel på under tre minutter i stedet for fem, eller atten før vi rørte testene.
Blacksmith for september indtil videre: 12,68 dollar i forbrug, hvoraf de 12 dækkes af den gratis kvote. Vi skylder dem 68 cent.
Opdeling køber tid, og du betaler stadig for hvert minut. Hvert job betaler for sin egen opsætning: at tjekke koden ud, installere afhængigheder, starte databasen. GitHub fakturerer hvert job per påbegyndt minut, så ti jobs på ét minut koster ti minutter og føles som ét. Det er det værd for en pull request, nogen venter på. For et natligt job, ingen holder øje med, så hold det samlet.
Kig på ARM tidligt. Hos Blacksmith koster et ARM-minut over en tredjedel mindre end et almindeligt Intel- eller AMD-minut (x64), og at flytte CI derover ændrer ikke på det, man leverer. Vi har kun prøvet det på ét repository indtil videre, og det passer ikke alle steder: vores Android-app må blive på x64, fordi Googles Android-byggeværktøjer ikke kører på Linux ARM.
At flytte resten
Vi har næsten halvtreds aktive repositories, og jeg vil ikke have, at hver migrering afhænger af, at nogen forstår netop den pipeline. Så jeg skrev processen ned som en skill til Claude, en drejebog, den følger trin for trin, når den flytter et repository over. Den måler før og efter, over flere kørsler frem for én heldig. Den tjekker, at caches faktisk bliver gendannet; en af vores var aldrig blevet det én eneste gang, og ingen havde lagt mærke til det. Og den prøver ARM, hvor intet udelukker det.
Fem repositories kører på Blacksmith indtil videre. Et startede der. Tre, heriblandt den primære webapplikation, kom over med Blacksmiths egen migreringsguide plus lidt hjælp fra mig, og et blev flyttet fra ende til anden af skill’en. De tidlige tal for de andre ser gode ud, fra en smule hurtigere til omtrent dobbelt så hurtigt, men de hviler på en håndfuld kørsler hver.
Efterlad pipelinen hurtigere, end du fandt den
Ingen holder fest, når CI virker. Når det er langsomt eller flaky, er alle hamrende irriterede. Det er en større del af jobbet, end vi har lyst til at indrømme, og det bliver langsomt, uden at nogen har besluttet det: nogle få tests ad gangen, indtil det en uge tager atten minutter, og alle stille og roligt er begyndt at arbejde uden om det.
Så jeg behandler det, som jeg behandler kode, med spejderreglen: efterlad pipelinen bedre, end du fandt den. Når jeg arbejder i et repository, kigger jeg på, hvor lang tid dets CI tager, og om dets caches virker, og hvis noget er åbenlyst langsomt, retter jeg det, mens jeg alligevel er der.
Med en agent koster det næsten ingenting. Jeg peger en mod repositoryet og lader den læse de tidligere builds, finde de langsomme trin, prøve en ændring, måle den, beholde det, der blev hurtigere, droppe det, der blev værre, og tage en runde til. Den kører i baggrunden, mens jeg arbejder på fejl og features, og den tager næsten ingen af min opmærksomhed. Skill’en skriver den løkke ned. Jeg vil gerne have, at det bliver alles vane, ikke kun min.
Tilbage til kaffen
Testsuiten vokser stadig, så en dag bliver pipelinen langsom igen. Med lidt held retter den, der opdager det, det, før kaffen er klar. Et sted, går jeg ud fra, træffer rygerne stadig de rigtige beslutninger. Jeg kan bare ikke længere bruge buildet som undskyldning for at slutte mig til dem.